HTTP 版本
快速阅读
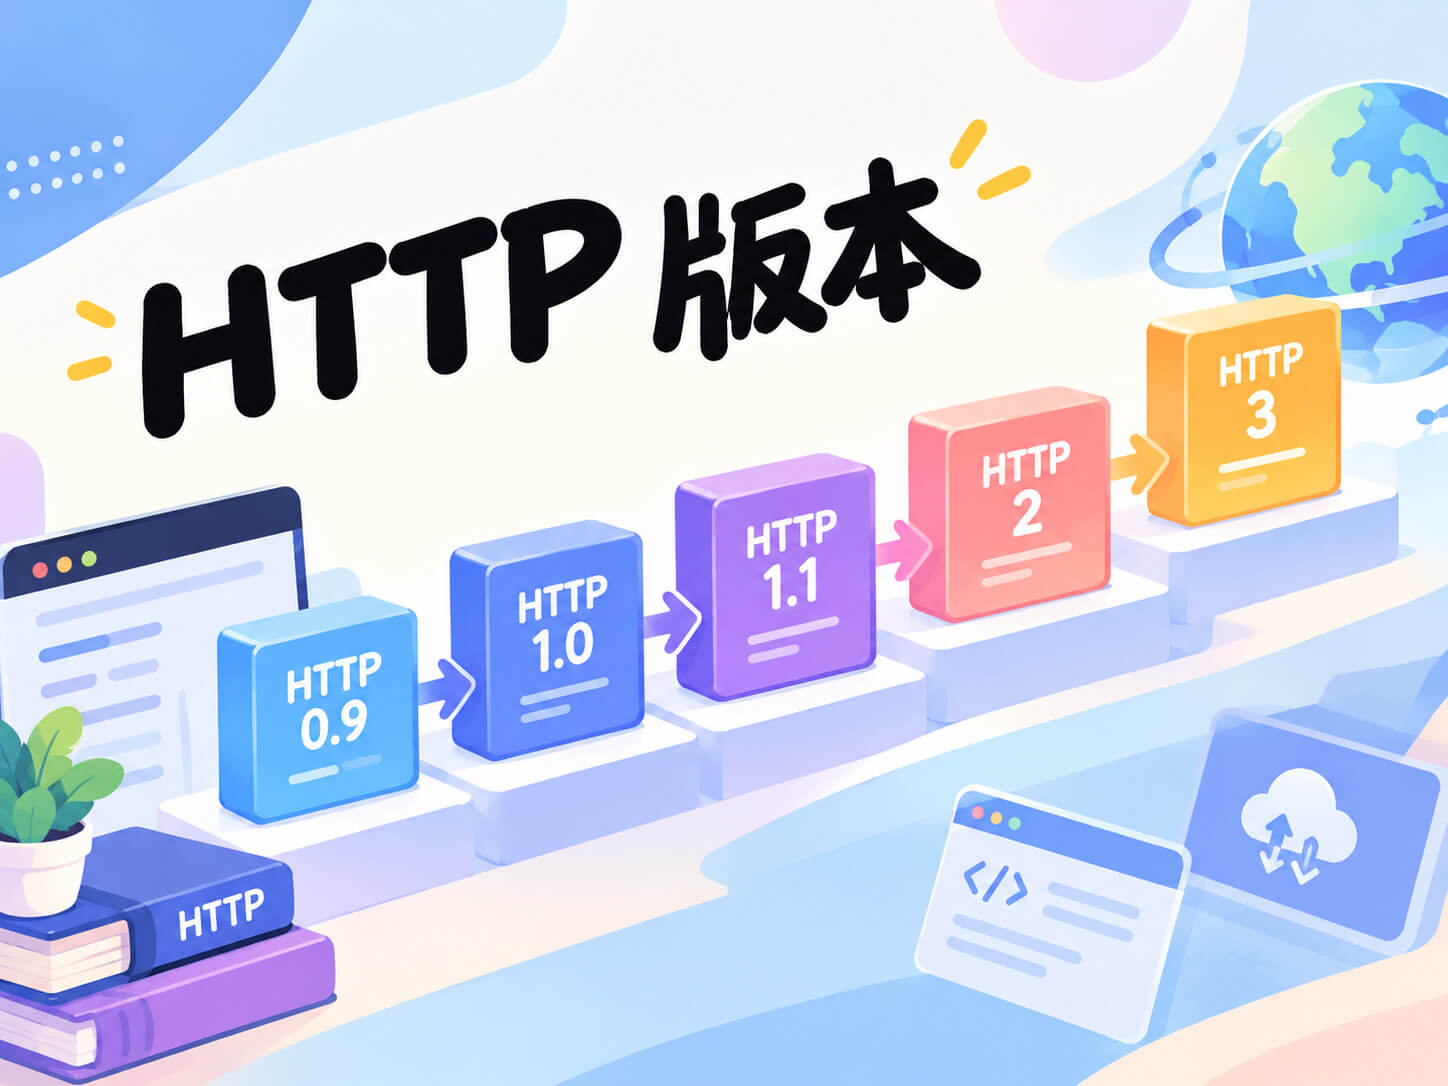
HTTP 的主要版本包括 HTTP/0.9、HTTP/1.0、HTTP/1.1、HTTP/2 和 HTTP/3。
HTTP/0.9 是 HTTP 协议的早期原型(不是正式发布的版本),HTTP/1.1 长期作为事实标准,而 HTTP/2 和 HTTP/3 是当前主流的 性能优化版本(主要是针对队头阻塞问题的优化)。
HTTP 协议的主要使用场景是浏览器,桌面应用和手机 App 调用后端接口、获取数据、上传文件,绝大多数也是 HTTP/HTTPS 协议。
HTTP 的版本选择是浏览器和服务端底层框架之间 自动协商 的结果,通常 不需要手动设置。
HTTP/0.9
基本概念
HTTP/0.9 是 HTTP 协议的最初实现版本,公开于 1991 年,它只是早期原型,没有经历正式的标准化发布流程,为了与后续版本区分,才被非正式地命名为 HTTP/0.9。
HTTP/0.9 的设计目标是为了在互联网上实现一种极简的超文本传输机制,让客户端能够从服务器获取 HTML 文档。
核心特征
1. 请求格式只有一行
请求由单行 ASCII 文本构成,格式为 GET /path/to/file,以回车换行符结束。请求中不包含 HTTP 版本号、请求头、请求体,也没有 Host 头,服务器仅凭这一行就能定位并返回文件。
Host 请求头是为了 区分同一个 IP 上部署的多个网站,而 HTTP/0.9 的时代没有多域名共享同一台服务器 IP 的场景,协议认为 TCP 连接对应的就是唯一的 Web 服务器。
2. 仅支持 GET 方法
HTTP/0.9 只定义了 GET 一种请求方法,客户端 只能获取资源,无法提交数据、删除资源或执行任何其他操作。
3. 响应仅支持 HTML 格式
协议默认且 只能传输 HTML 文档,服务器会直接将请求的 HTML 文件内容以 ASCII 字符流返回,没有状态行和响应头,客户端收到的就是裸文件内容。
4. 依靠连接关闭判断响应结束
服务器发送完整个文档后主动关闭 TCP 连接,客户端 通过连接关闭来判断响应已结束。
5. 没有错误处理机制
请求出错时,服务器通常会返回一个包含错误描述的 HTML 页面,客户端 无法自动识别成功或失败。
6. 基于 TCP 协议
协议完全依赖 TCP 提供 可靠传输,自身不处理重传、排序等机制。
TCP 向应用层提供了一个 可靠的、面向连接的字节流服务,应用层不需要关注如何实现可靠传输,这是网络分层意义的直接体现,每一层只解决自己该解决的问题。
7. 连接不可复用
每次请求都需要建立一个新的 TCP 连接,响应完成后就关闭连接。
报文示例
请求报文
1 | GET /papers/accelerator.html |
响应报文
1 | <HTML> |
HTTP/1.0
基本概念
HTTP/1.0 是第一个 具备广泛实际应用价值 的 HTTP 版本,其规范记录于 1996 年发布的 RFC 1945。
HTTP/1.0 在 HTTP/0.9 的基础上做了大量扩展,使万维网从纯文本传输工具演变为能承载丰富媒体内容的平台。
RFC(Request for Comments)是 记录互联网技术规范与标准 的正式文档系列,每个 RFC 文档都有唯一的数字编号,例如 RFC 1945 是 HTTP/1.0 协议的官方规范文档。
万维网(World Wide Web)是 互联网(Internet)之上的一种信息服务,它依靠 HTTP 协议传输资源,用 URL 定位资源,用 HTML 描述页面,用浏览器呈现内容。
核心特征
1. 引入结构化的消息格式
请求和响应都必须包含起始行(包括协议版本,如 HTTP/1.0)和头部字段,空行之后才是可选的数据体。
2. 支持多种请求方法
除了已有的 GET 方法外,HTTP/1.0 还引入了 POST 和 HEAD 方法。POST 允许客户端向服务器提交数据,HEAD 用于只获取响应头而不获取响应体。
3. 支持多种内容类型
通过 Content-Type 头,服务器可以明确告知客户端返回数据的格式,HTTP/1.0 开始支持图像、音频、视频及各类二进制文件。
HTTP/1.0 本身并不内置图片、视频这类资源的硬编码支持,它 传输的永远是字节流,但允许发送方用 MIME 类型声明字节流的数据格式,理论上就可以传输任何类型的数据。
4. 依靠 Content-Length 判断响应结束
如果服务器在响应头中提供了 Content-Length 字段,客户端就依据这个值来 读取固定长度的字节;如果响应头中没有 Content-Length,客户端就通过 TCP 连接关闭来判断响应已结束。
5. 引入状态码
状态行中包含三位数字的状态码(200 OK、404 Not Found 等),让客户端能够 用程序化的方式判断请求结果。
HTTP/1.0 本身不支持持久连接,客户端可以在请求头增加 Connection: keep-alive,如果服务器支持并同意,会在响应中回传相同的头部,连接便得以保持。但这 不属于标准的协议规范,存在兼容性问题。
6. 实现缓存机制
HTTP/1.0 实现了 强制缓存 和 协商缓存。
HTTP/1.0 通过 Expires 响应头控制强制缓存。它给出一个绝对的过期时间,在这个时间之前,浏览器可以直接使用本地缓存,不向服务器发送请求。主要缺陷是 依赖客户端与服务器的时间一致性,时钟偏差会导致缓存判断出错。
HTTP/1.0 通过 Last-Modified 响应头和 If-Modified-Since 请求头控制协商缓存。服务器在首次响应中返回 Last-Modified 代表 资源的最后修改时间,浏览器在后续请求中携带 If-Modified-Since,服务器比对后决定返回 304 Not Modified 还是 200 OK。
报文示例
请求报文
1 | GET /images/pic.png |
Host 请求头是在 HTTP/1.1 中才成为 强制要求 的,在 HTTP/1.0 中,它并不是一个必须包含的字段。
响应报文
1 | 200 OK |
HTTP/1.1
基本概念
HTTP/1.1 是 HTTP 协议 使用最广泛、生命周期最长 的版本,其核心规范最初由 1997 年发布的 RFC 2068 定义,经过 RFC 2616(1999 年)修订后定型。
HTTP/1.1 在 HTTP/1.0 的基础上,重点解决了 连接效率问题,并完善了协议的基础设施。
核心特征
1. 默认持久连接
这是 HTTP/1.1 的标志性改进,它将持久连接定义为 默认行为,不需要设置 Connection: keep-alive 请求头。同一条 TCP 连接可以复用于多个连续的请求,避免了反复握手与慢启动的开销。
keep-alive 在 HTTP/1.0 时代是非正式的 自定义扩展值;在 HTTP/1.1 时代,持久连接成为默认机制,keep-alive 从未被正式定义。
客户端发起一个携带 Connection: close 的请求时,可能会复用当前连接池中的 TCP 连接,如果没有可用的空闲连接,就会新建一条,但不管这条连接是否属于新建的,本次请求响应完成后,都会关闭这条 TCP 连接。
Connection: close 的对象可能是复用的连接,也可能是新建的,它的使用目的只是 为了让请求退回短连接模式,避免出现一些异常情况,实际很少使用。
浏览器可以同时维护多条独立的 TCP 长连接,连接池通常以 源(Origin,即协议 + 主机 + 端口)作为分组键,发送请求时,浏览器会在这个源对应的连接池中查找可用的空闲连接。请求处理完成后,如果没有显式设置 Connection: close,连接就不会立刻关闭,而是进入空闲状态,等待同源请求复用。
对底层 HTTP 客户端而言,任意连续的请求都可以复用同一条 TCP 连接,但浏览器增加了 Origin 连接池隔离,只有同源请求才能复用连接。
TCP 本身是通过 IP + 端口 连接的,但 HTTP 属于应用层协议,浏览器 必须按源来判断能否复用。a.example.com 和 b.example.com 可能解析到同一个 IP,但它们是不同的站点,HTTP 层必须区分。
2. 强制要求 Host 请求头
HTTP/1.1 将 Host 请求头列为必须包含的字段,服务器若收到不含 Host 的 HTTP/1.1 请求,应返回 400 Bad Request。这一变化 确保了基于域名的虚拟主机技术能够可靠运作。
3. 引入分块传输机制
如果响应头没有携带 Content-Length 字段,客户端可以通过 TCP 连接关闭来判断响应结束,但 HTTP/1.1 默认为长连接,为了能够 识别未知长度的响应体何时结束,HTTP/1.1 引入了 Transfer-Encoding: chunked,允许服务器将数据划分成若干块发送,最后以零长度块结束。
4. 新增请求方法和状态码
HTTP/1.1 定义了除 PATCH 外的其余 HTTP 请求方法,并补充了大量状态码。
Range 范围下载 以及对应的 206 Partial Content 状态码也是 HTTP/1.1 定义的。
5. 缓存机制增强
HTTP/1.1 的强制缓存从 绝对时间 增强为 相对时间,协商缓存从 时间戳 增强为 内容指纹。
HTTP/1.0 的强制缓存依赖 Expires 头,它给出一个绝对时间。HTTP/1.1 引入了 Cache-Control,通过 max-age 相对时间控制强制缓存,优先级比 Expires 更高。
HTTP/1.0 的协商缓存基于 Last-Modified 响应头和 If-Modified-Since 请求头,时间精度只到秒级,且无法区分内容没变但修改时间变了的情况。HTTP/1.1 新增了 ETag 响应头和 If-None-Match 请求头,通过内容指纹控制协商缓存,优先级比 Last-Modified 更高。
报文示例
请求报文
1 | GET /log |
响应报文
1 | 200 OK |
HTTP/2
基本概念
HTTP/2 最初由 2015 年发布的 RFC 7540 定义,经过 RFC 9113(2022 年)修订后定型,是现代浏览器中使用占比最高的协议版本。
HTTP/2 的核心目标是解决 HTTP/1.1 的性能瓶颈,它 重新设计了 HTTP 语义在 TCP 连接上的传输方式。
核心特征
通过二进制分帧实现多路复用
在响应中增加一个请求 ID 字段,就能让客户端知道该响应属于哪个请求,但 TCP 要求按序交付,假设第一个请求的响应很大,其他请求的响应很小且先准备好了,服务器也不能把其他请求的响应插队发出去,其他请求的响应要么排在第一个请求后面,要么只能 再开一条 TCP 连接,这正是 HTTP/2 想要消除的低效做法。
TCP 协议在传输过程中收到的是乱序的分段,但会根据序列号重组,最后 按序交付给应用层。
HTTP/2 的核心设计思想是 用更少的连接承载更多的并发,减少 TCP 和 TLS 握手的开销,降低服务器维护大量连接的压力。HTTP/2 把一个响应拆分成多个二进制帧,这样属于不同流的帧就能 交错发送,接收方根据帧头的 Stream ID 重新组装即可。经过拆分后,慢请求的帧就不会堵住快请求的帧,因为它们在传输层面就是 可以穿插的独立单元。
一条 TCP 连接上可以同时打开多个流,每个流对应一个请求和响应,不同流的帧可以交错发送,这就是 多路复用。
HTTP/1.1 的报文是 文本格式 的,属于可读的 ASCII 字符,解析报文需要逐字符扫描、按空格和换行切分;HTTP/2 把所有通信内容都编码成 二进制格式,可以直接用位操作解析。
二进制分帧是为了在同一条 TCP 连接上插队发送,避免已就绪的响应被阻塞。HTTP/2 通过二进制分帧,在单条 TCP 连接上实现了多路复用。
报文示例
HTTP/2 的报文是一系列二进制帧,无法像 HTTP/1.1 那样直接写成可读的文本。
请求帧
1 | HEADERS 帧,Stream ID=1, END_HEADERS, END_STREAM |
响应帧
1 | HEADERS 帧,Stream ID=1, END_HEADERS |
HTTP/3
基本概念
HTTP/3 是 HTTP 协议的最新正式版本,由 2022 年发布的 RFC 9114 定义。
HTTP/3 弃用了 TCP,以基于 UDP 的 QUIC 协议作为传输层,解决了 HTTP/2 遗留的 传输层队头阻塞 问题。
早期的 HTTP 协议使用 TCP 作为传输层,是因为 TCP 提供了可靠传输,并且当时没有更好的替代方案;直到 QUIC 成熟后,才在 UDP 上实现了可靠传输,成为 HTTP/3 的基础。
核心特征
基于 QUIC 协议
HTTP/2 通过二进制分帧解决了 应用层的队头阻塞,但 TCP 本身是单字节流协议,它对上层有多少个 HTTP 流无感知,一旦发生丢包,TCP 会 阻塞该连接上所有数据的交付,直到丢包重传完成。
HTTP/3 的 QUIC 协议原生支持独立流,每个流的数据单独处理,一个流发生丢包,只会影响该流本身,其他流的数据可以继续被接收。
丢包对应的是某个 TCP 分段,TCP 可能把一个帧拆成多个分段,也可能把多个帧合进一个分段。TCP 需要把多个分段完整合并后再交付给应用层,缺失的分段未补齐前,后续到达的数据只能在缓冲区等待。
报文示例
HTTP/3 基于 QUIC,属于二进制协议,没有文本报文。
请求帧
1 | HEADERS 帧,Stream ID=1, END_HEADERS, END_STREAM |
响应帧
1 | HEADERS 帧,Stream ID=1, END_HEADERS |
HTTPS
基本概念
HTTPS(Hypertext Transfer Protocol Secure)即 安全的超文本传输协议。HTTP 报文是 可读的字节流,从客户端到服务器的路径上,任何 应用层中间节点(代理服务器、网关等)都能直接读取内容,存在安全风险。HTTPS 通过 TLS/SSL 协议对 HTTP 报文进行加密,防止数据被窃听、篡改或伪造。
NAT(Network Address Translation)即 网络地址转换技术,用途是 让多个内网设备共享同一个公网 IP,同时对外隐藏内网结构。
交换机本身不提供私有 IP,私有 IP 是路由器的 DHCP 服务 动态分配 的。
实现原理
HTTPS 在 HTTP 与 TCP 之间加入了 TLS 握手过程,先用非对称加密和数字证书安全地协商出一个 会话密钥,之后再用这个对称密钥加密实际的 HTTP 报文。
SSL 和 TLS 是 同一技术的两代协议,TLS 是 SSL 的标准后继。现代 HTTPS 底层用的都是 TLS,SSL 已经全部废弃。
非对称加密涉及大数运算,速度比对称加密慢几个数量级,不适合加密大量业务数据,因此在 HTTPS 中,非对称加密只是用来协商对称加密的密钥,实际报文是通过对称密钥进行加密的。
在非对称加密中,密钥对通常由解密方生成。公钥用于加密,可以公开上传;私钥用于解密,不能泄漏。
报文示例
HTTPS 的报文是对称加密的,TCP 上传输的是不可读的 TLS 记录。
请求方向
1 | TLSv1.3 Record Layer: Application Data Protocol |
响应方向
1 | TLSv1.3 Record Layer: Application Data Protocol |